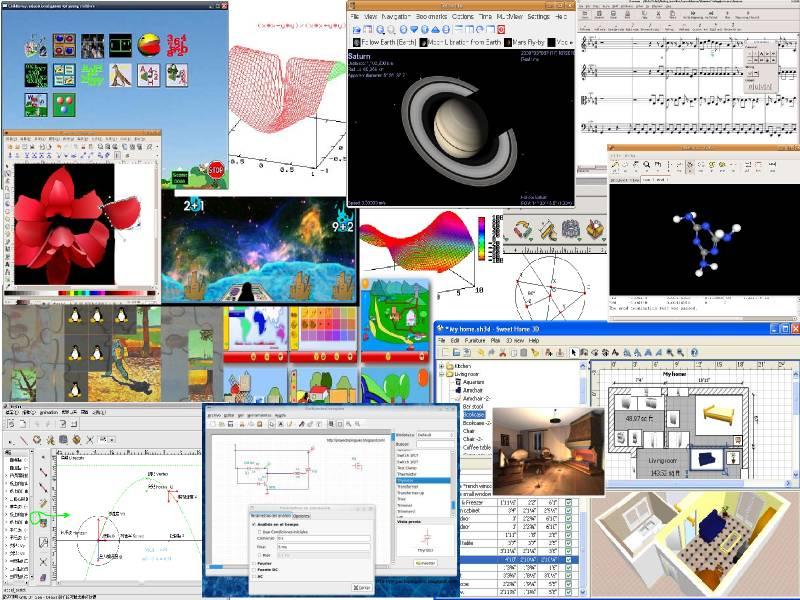
 大人問小孩: 「全世界的玩具隨便你挑? 這怎麼可能?
如果我要的玩具只有一個, 正好又被別人借走了呢?」
Line 沒有很好的文字搜尋的功能、 在電腦版 (chrome 擴充套件) 上面只能保留兩週的訊息、 即使是公開的群組也沒有 https 的網址可以分享、 ... 有各種不方便。 最近寫了一隻小程式 "linespector" 可以從電腦版把某個群組的近期文字對話內容與 (低解析度) 圖片全部合併儲存到一個 sqlite 資料庫檔案裡面, 再用 php 以網頁的方式呈現。 我拿它來把社區的 line 群組轉成網頁, 在內部的網站公告。 (當然事先已徵得群組管理員與成員同意) 或是你只是想備份某群組的對話作為 (不必仰賴雲端的) 個人懷念/記錄, linespector 也幫得上忙。
2023年8月25日 星期五


2019年8月19日 星期一
網頁表格轉 csv, 瀏覽器 inspector 手動剪貼版
玩資料視覺化, 經常需要從網頁上下載表格, 再轉成 csv。
以前就曾搜尋到
sebsauvage.net 上面的 html2csv.py,
後來忘記了; 最近又重新發現一次。
很簡單: python2 html2csv.py abc.html 它會把 abc.html
裡面的所有表格串在一起, 產生一個 abc.csv 。
如果有合併列或合併欄等等比較複雜的狀況, 還是需要後續處理,
但至少比自己寫 regexp 簡單多了。 全文完。
 喂~ 這樣就結束? 這篇未免太 ㄌㄢˋ ㄩˊ ㄔㄨㄥ ㄕㄨˋ 了吧!
[現在有同音異字的成語太多了, 我都不知道國字該怎麼寫才對...]
至少應該要交代一下如何取得 html 啊。 如果是大量的靜態網頁,
可以用 wget 或 lynx -dump 或 curl 取得。
有可能需要
設定 user agent 才不會被網站拒絕。
如果是 javascript 所動態產生的、 上述指令無法取得的網頁呢?
如果頁面數量很多, 那就考慮用
puppeteer。 如果只是單一或少數的 [js 動態產生的] 頁面,
那就手動另存新檔就好。
可是有一些 js 頁面需要你點幾個地方之後, 才會動態填值進表格。
這時 firefox 的 console 就很好用了 --
即使不是 js 程式設計師也值得學一下。
2019年2月16日 星期六
網頁爬蟲終極武器: puppeteer
2019年2月7日 星期四
網頁畫面定時快照截圖
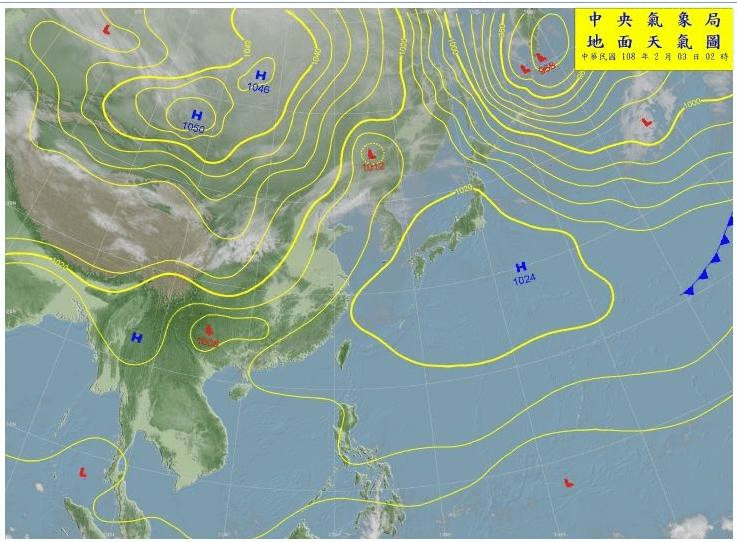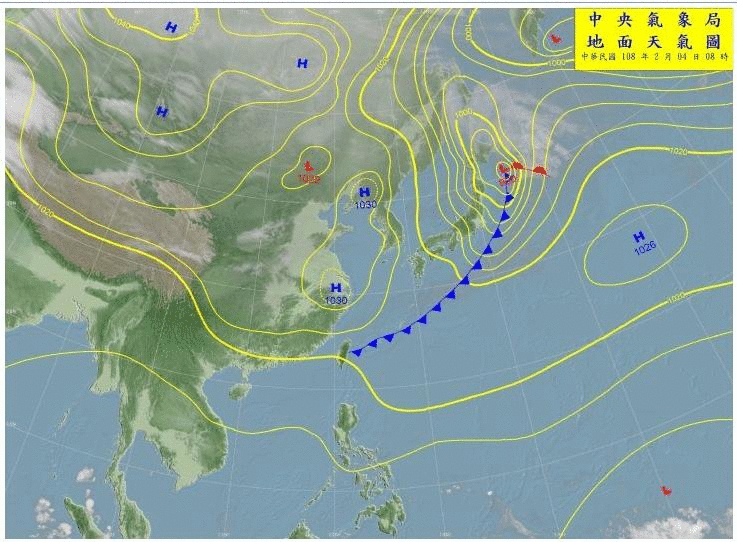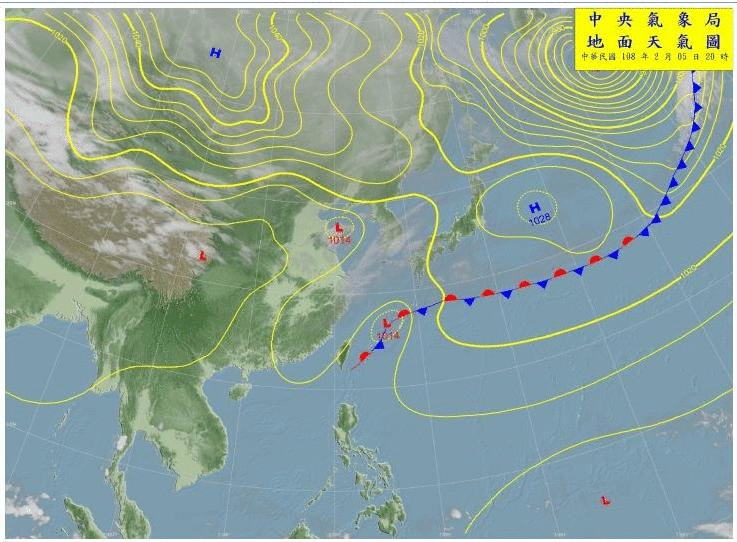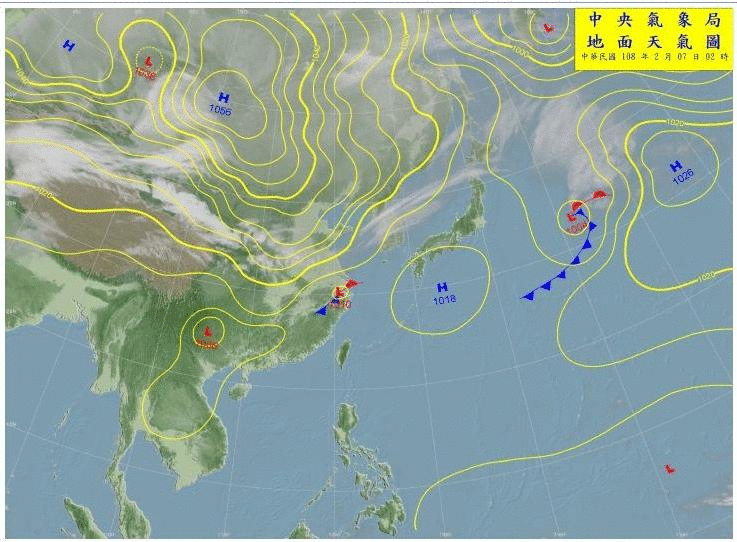 想要定期下載某網頁, 可以在 cron job 裡面用 wget。
[
鳥哥、
教育大市集] 但這僅適用於伺服器端產生的靜態網頁。
如果是 javascript 產生的動態網頁呢?
如果需要取得網頁文字內容, 那就必須用比較進階的
網頁爬蟲終極武器: puppeteer;
如果只需要快照截圖 (例如想要觀察 google 地圖或開放街圖某塊區域的長期變化),
那麼本篇介紹的 cutycapt 就夠用了。
2018年8月30日 星期四
用 lynx 加 perl 的 csv 句型從網頁裡的表格產生試算表
如果說
三大 regexp 句型 是 「懶得學 perl 程式語言的系統管理員必學的三句 perl」,
那麼今天要介紹的就是第四重要的 perl 句型:
perl -F, -nale 'print join(",", @F[2,5,6])'
姑且就稱它為 perl 的 csv 句型吧。
它跟文字瀏覽器 lynx 合作, 可以把網頁的表格抓下來變成試算表。
當你不想為了一點小事開啟 calc 時, 就用它們來馴服 .csv 檔吧。
2017年12月3日 星期日
用 GRASS 繪製燦坤各分店的勢力範圍地圖 Voronoi Diagram
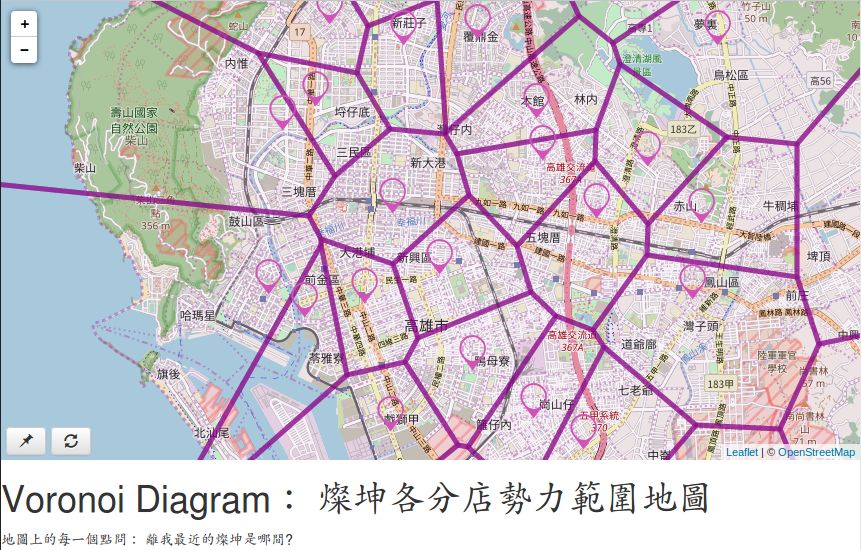 想像你有一張 「中華電信基地臺分佈地圖」,
並且假設每個基地臺的功率都一樣大。
地圖上的每一個點都可以問: 「哪一個基地臺離我最近?」
以便決定哪個基地臺的訊號比較強、 我的手機要跟誰連線。
以 (不會移動的) 「偶像 - 粉絲」 之間的關係來比喻,
每個偶像有自己的勢力範圍, 範圍內的所有點就是它的粉絲。
各勢力範圍之間的分界線由相鄰兩偶像的垂直平分線所組成。
這樣畫出來的圖稱為 Voronoi Diagram。
因為我拿不到基地臺座標, 所以只好改畫燦坤各分店的勢力範圍地圖。
目前可能沒什麼用, 因為分店跟粉絲的直線距離沒有太大意義;
但以後出現無人機送/取貨業務時, 這張地圖可能就有用了。
2017年11月16日 星期四
用 TGOS 全國門牌地址定位服務繪製全家便利商店全國門市地圖
[2022/9/7 現在改推另一個範例: TGOS 批次地址查經緯度 + umap 私房地圖範例: 清冠一號中醫診所地圖] 至於本篇舊文, 可以直接跳到 TGOS 重點提示 那一節查看 TGOS 服務的使用方式。
一、 下載 「全家門市」 地址
這篇我們要列出某大規模連鎖店的全國門市、 用內政部資訊中心所提供的 「批次地址比對服務」 把門牌號碼轉成經緯度、 最後再匯入 umap 私房地圖。 全家門市查詢 有簡單的靜態網頁, 最容易處理, 那就決定用全家當範例了。 用 wget 把所有網頁抓下來, 如 FamilyMart.tgz (包含下面成果的打包壓縮檔)。
2017年8月24日 星期四
按照類別下載 ImageNet 訓練圖片的一小部分
影像辨識之 caffe 初體驗 當中所用到的模型及權重矩陣, 它的訓練資料來自 ImageNet。 因為著作權的關係 blah blah... 所以 Princeton 大學跟 Stanford 大學不敢直接提供所有圖檔讓大家下載。 事實上, 總共有一千四百多萬張圖檔, 對於我們這些沒有 GPU 的人來說, 全部下載根本沒有意義, 也太不環保了。 比較實用的, 是根據標籤下載其中幾個類別的圖片, 以便做小規模的 transfer learning 等等。
2016年3月13日 星期日
網頁搜括小工具: 用 extract.php 擷取網頁當中的一小塊
用 php 的 querypath 或 javascript 的 jquery 可以擷取網頁的一小部分, 比方說部落格文章的正文部分。 但是每次都要寫一支用丟即棄的小程式也蠻沒效率的。 所以我寫了一支可以重複使用的小程式 extract.php, 以後只需要在命令列上用一個 css selector 語法就可以擷取網頁的一小塊了。 先前還沒有很好的 3G/4G 上網方案時, 我就是用這個工具下載一堆網頁以便離線瀏覽。 此外, 英文報讀軟體 coolreader 遇到太複雜的 html 檔也會掛掉, 所以就算數據上網不是問題, 這也很有幫助。 再比方說我 備份自己的部落格 (或別人的部落格也可以) 也是用這支小程式。
2013年4月5日 星期五
搜括網頁實戰入門: 用 firebug 跟 QueryPath (php 版的 jQuery) 學 DOM 跟 XPath
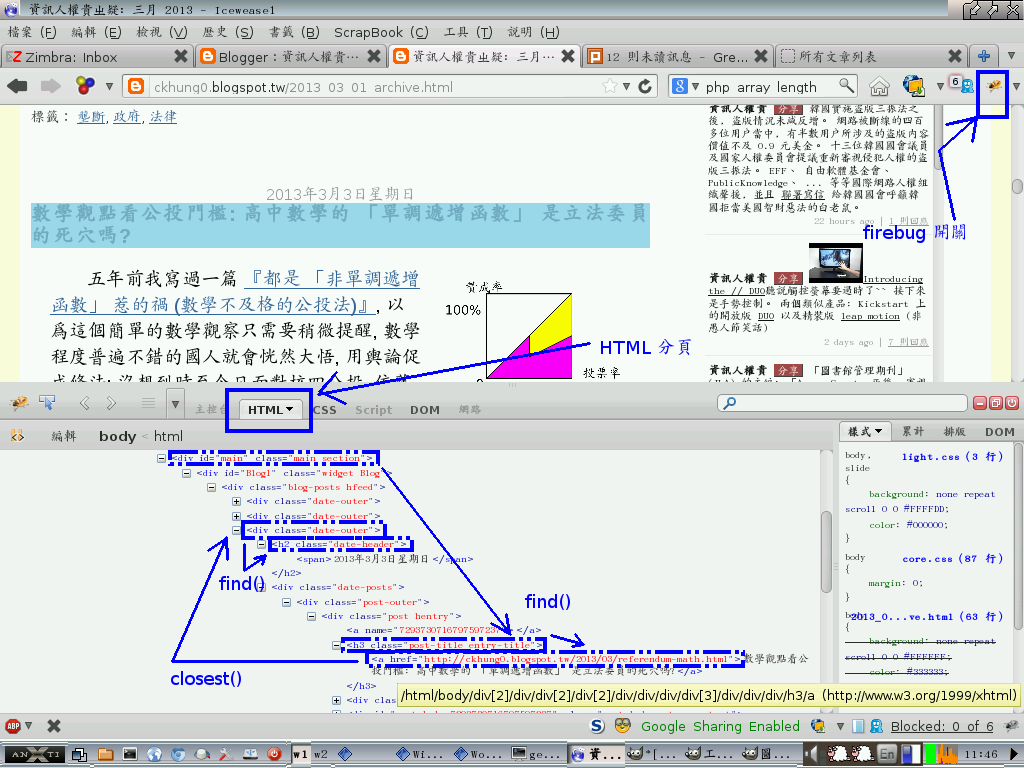 你會固定去某些部落格或新聞網站查看或下載文章/資料嗎?
希望把這些動作自動化 (省略手動點連結的動作) 批次化嗎?
或是你想寫一些小程式定期觀察某些網頁的某些欄位?
也許你需要學習 Document Object Model 跟 XPath?
總之, 如果你需要寫小程式抓取並分析網頁 (web scraping),
那就讓 firebug 跟 QueryPath (php 版的 jQuery) 來幫你吧。
本文介紹的是
2.1.2 3.0.5 版。
[2016/9/8 改用新版 QueryPath 重新檢查過本文。
2.1.2 版要這樣引用
require_once 'QueryPath/QueryPath.php';
而 3.0.5 版要這樣引用
require_once 'QueryPath/qp.php';
本文只介紹很基本的功能, 所以除了以上及安裝方式不同之外,
沒有其他大修改。 ]
訂閱:
文章 (Atom)

 發表文章


 本站文章採