 大人問小孩: 「全世界的玩具隨便你挑? 這怎麼可能?
如果我要的玩具只有一個, 正好又被別人借走了呢?」
自助餐的好處是有很多中低價位的菜色可以挑, 而且每一種菜的份量你可以自己決定。 Inference provider 類型的 NeoCloud 提供了很多開放權重的 LLM 模型, 就像自助餐店一樣。 比自助餐點更棒的是: 你在這裡也可以點牛排或松露, 呃, 我是說前沿模型。 他們通常會跟 Anthropic、 OpenAI、 Google 等等大廠合作, 所以他們的客戶也可以 (不需要固定訂閱! 而是) 按用量計價地使用最先進、 最昂貴的模型。
OpenRouter 就像是佈滿自助餐店的美食街或夜市, 而且你指定每一樣菜的時候, 它還會自動幫你挑最便宜或最好吃的那一攤, 直接送到你面前。 也就是說你點的雞腿可能來自 A 攤, 蒸蛋卻是來自 B 攤, 外加 1/3 片王品菲力牛排。 當然, OpenRouter 本身也會抽取手續費, 目前是 5.5%。
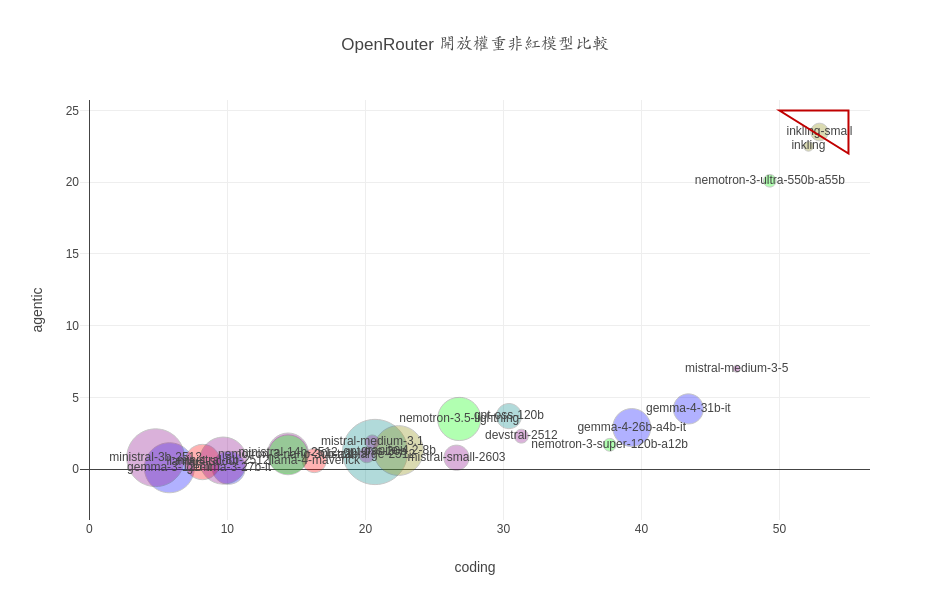
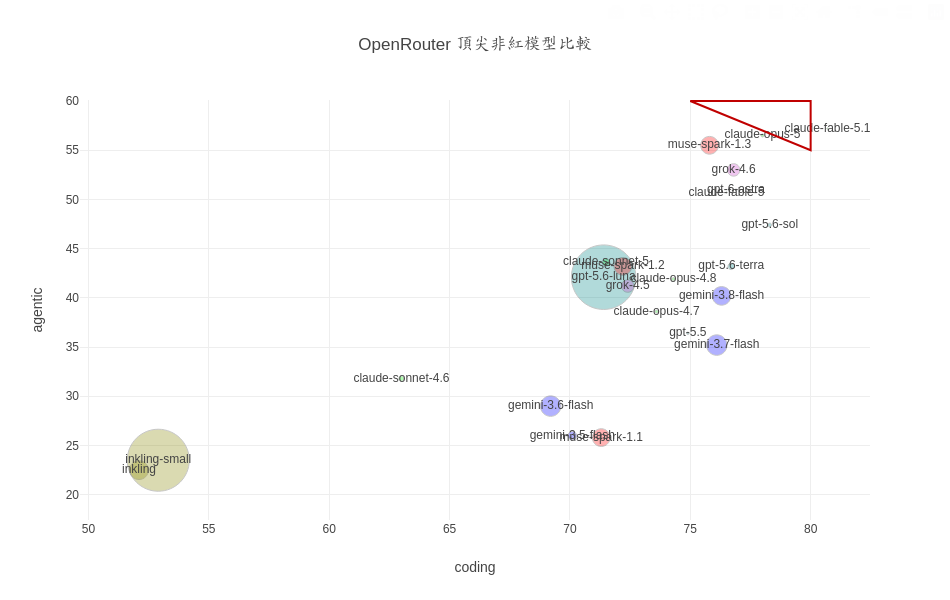
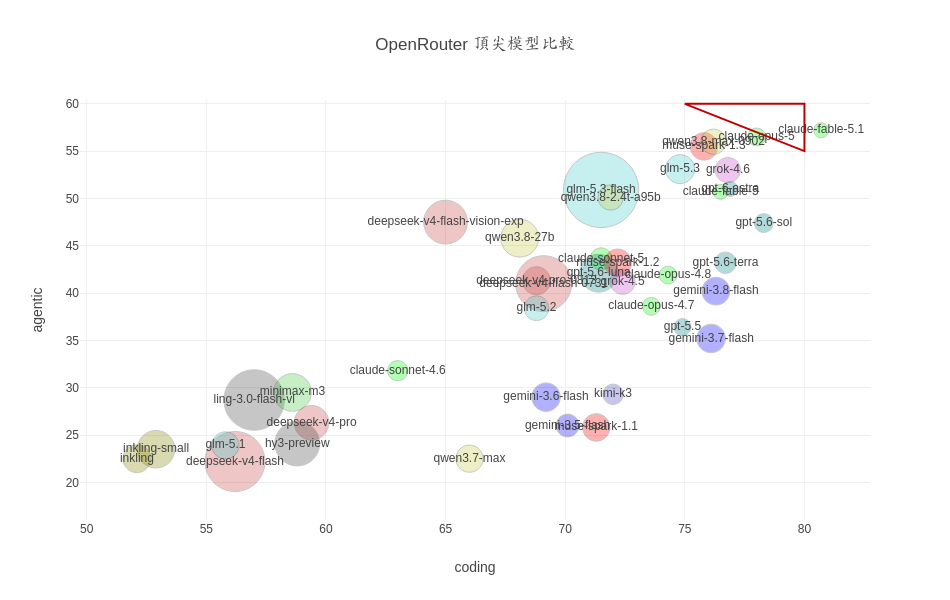


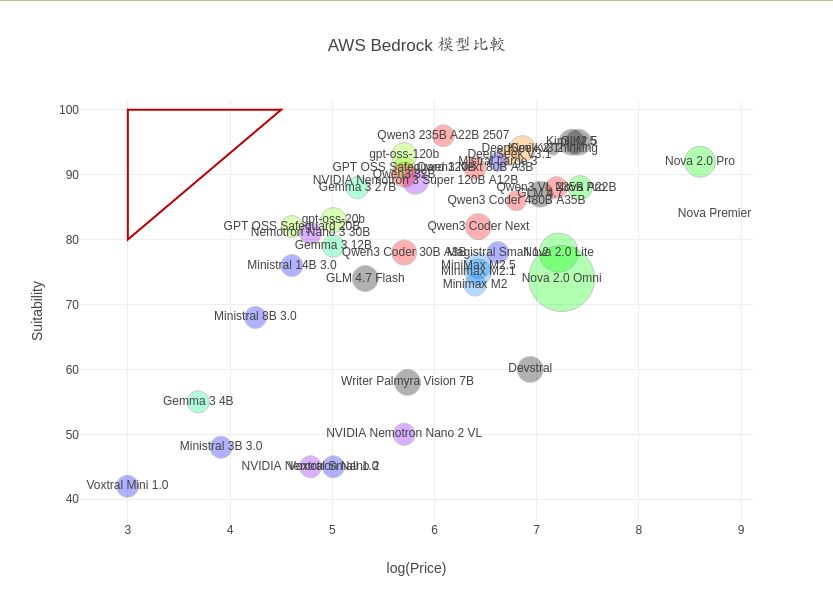 你挑了一個 LLM 租賃服務, 它提供很多模型。 該怎麼選?
我就拿 aws 的 bedrock 為例來解說資料視覺化 (散點圖/氣泡圖)
如何幫我們挑選性價比最佳的 LLM。
這些步驟應該也大致適用於比較整理其他 (來自同一家) 供應商的模型清單 -
只要你可以先建立一個 csv 檔列出該廠商提供的所有選項,
類似
 想知道誰最常跟莉雅公主同框嗎? 不用人工計算,我們用幾行指令就能畫出來。
 這是舊聞,不過很適合拿來當媒體識讀的教材。 2022 年 11/23 左右,
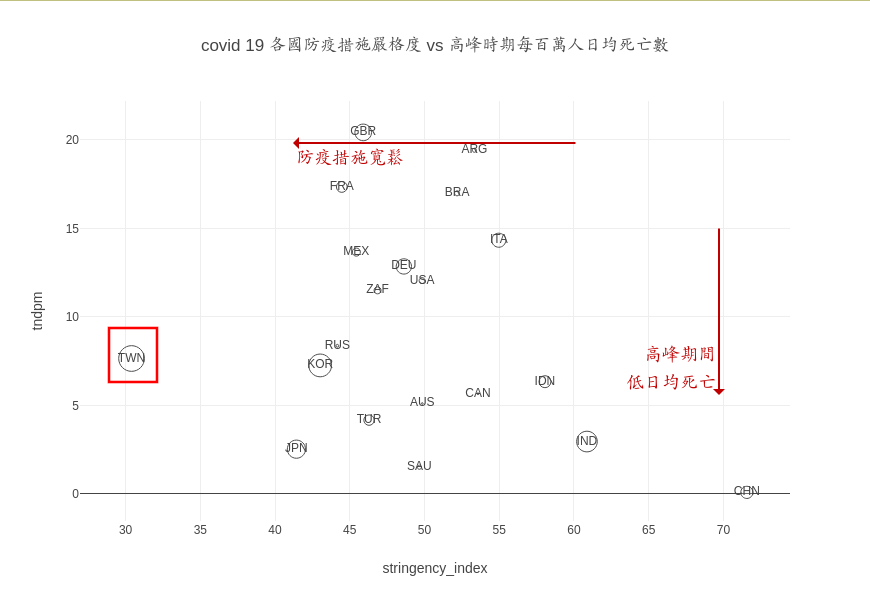
正值台灣武肺疫情高峰期間,
突然出現大量 「近二週致死率全球第三高」 的新聞。
這是 mal-information 的例子: 可能是事實, 但有惡意誤導的意圖。


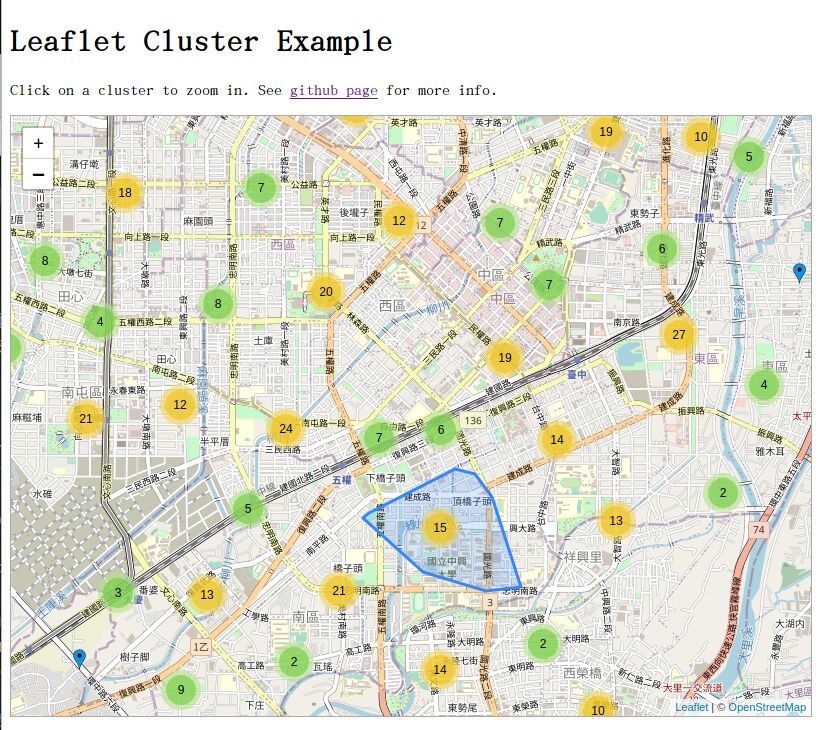 上個學期教資料視覺化,
其中一個主題是繪製客製地圖, 就做了這個例子:
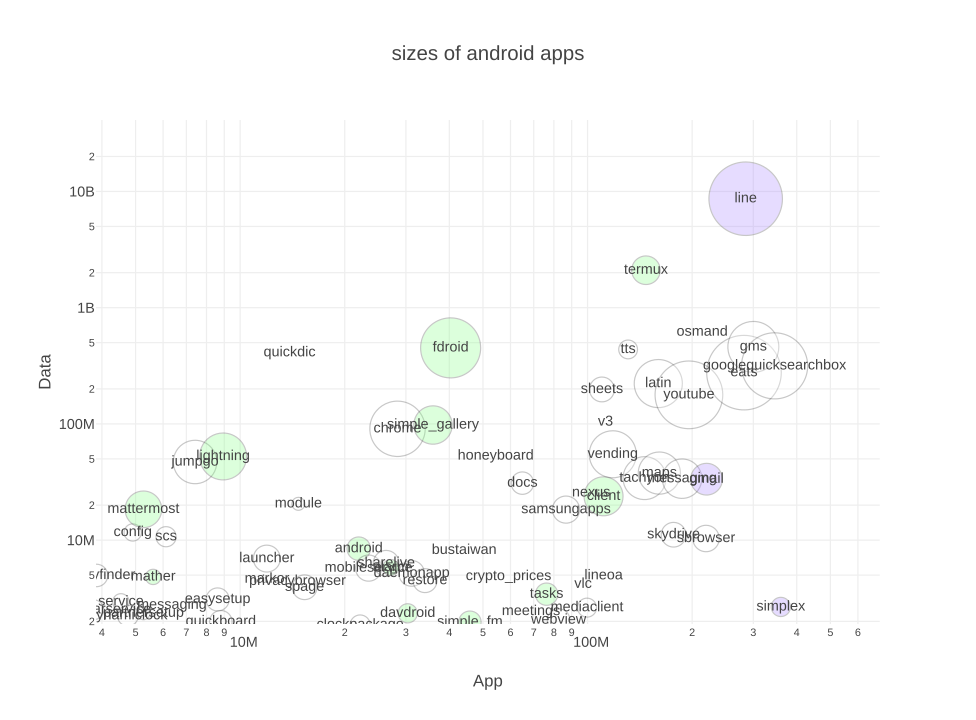
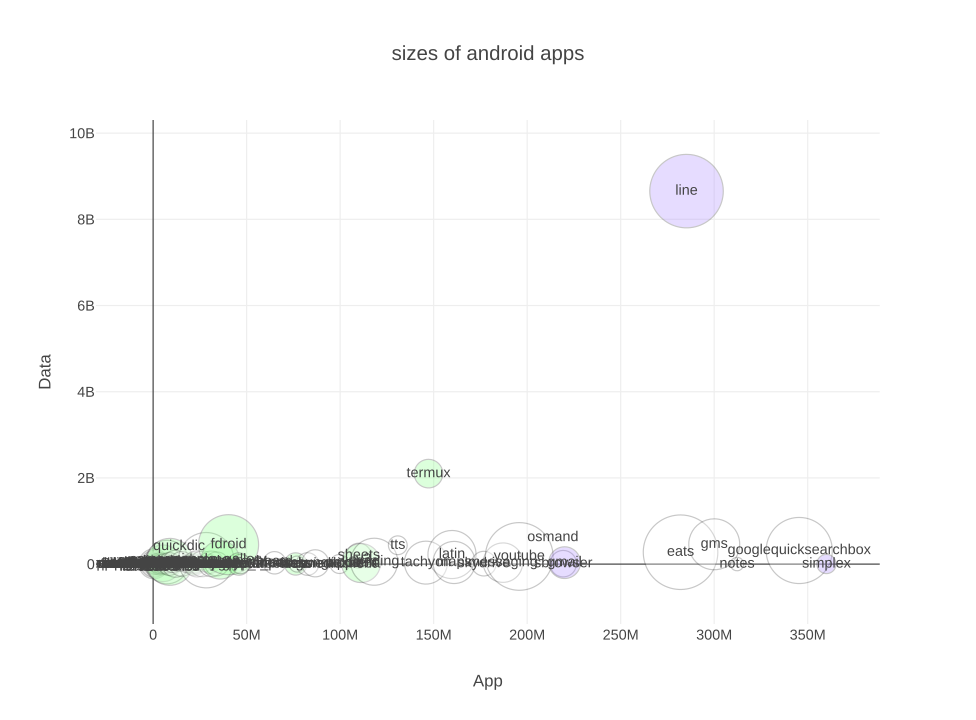 [25/10/02 更新] 在我的三星平板上, 自己可以安裝/刪除的軟體當中,
line 是腫脹軟體 (bloatware) 第一名。 那你的手機呢?
 大選過後, 一直想畫 「X黨 vs Y黨在各縣市得票比例對照圖」。
過年時節在家躲疫情, 終於有時間完成了一個小專案放到 github 上:
 資料視覺化的
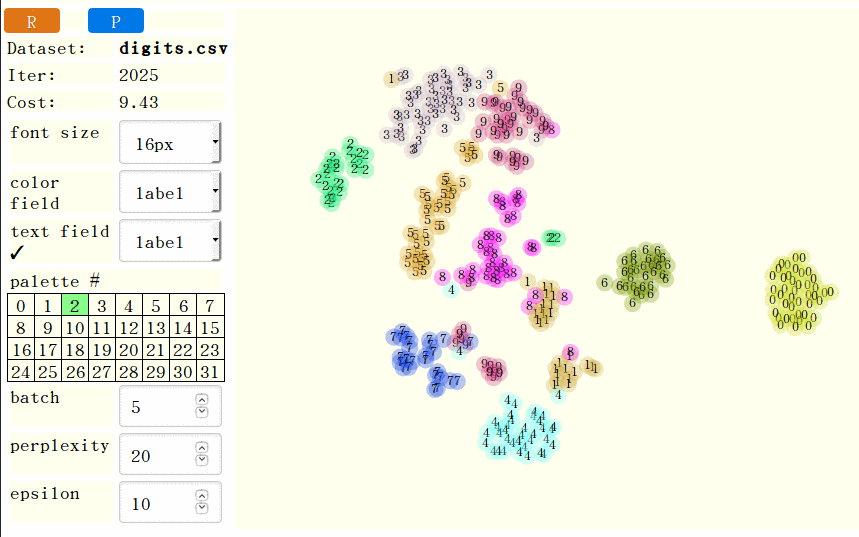 想像你有一個試算表, 裡面有幾十個數值欄位,
還有幾個 「分類用」 的字串欄位。
你想問: 如果我拿到一筆資料的所有數值欄位,
是否可以猜出它屬於哪一個分類?
比方說, 已知一個人的身高/體重/BMI/心跳速率/血壓/睡眠時間/肝指數GOT、GPT/...
是否可以猜出他比較可能是哪一種血型/星座/生肖/職業/...?
(有點毛毛的例子, 不過也正好提醒大家:
現代的趨勢就是這樣 -- 你的隱私, 就是政府或大企業手中的大數據。)
這是機器學習領域裡面典型的分類問題 (classification)。
如果資料量不大 (例如只有幾百筆或幾千筆資料、
每筆只有幾十個或幾百個欄位),
可能不足以拿來訓練複雜的人工智慧演算法; 又或者你有大量的資料,
但想要在全力運算之前小量取樣,
並且用一個操作簡單運算量較低的演算法、
以不是很精確但可以視覺化的方式迅速了解你的資料長相。
這時, 屬於非監督式學習類型的 t-SNE
演算法就非常適合拿來用肉眼觀察資料的群聚/分類現象。

 發表文章


 本站文章採